
Imagem gerada por inteligência artificial (ChatGPT)
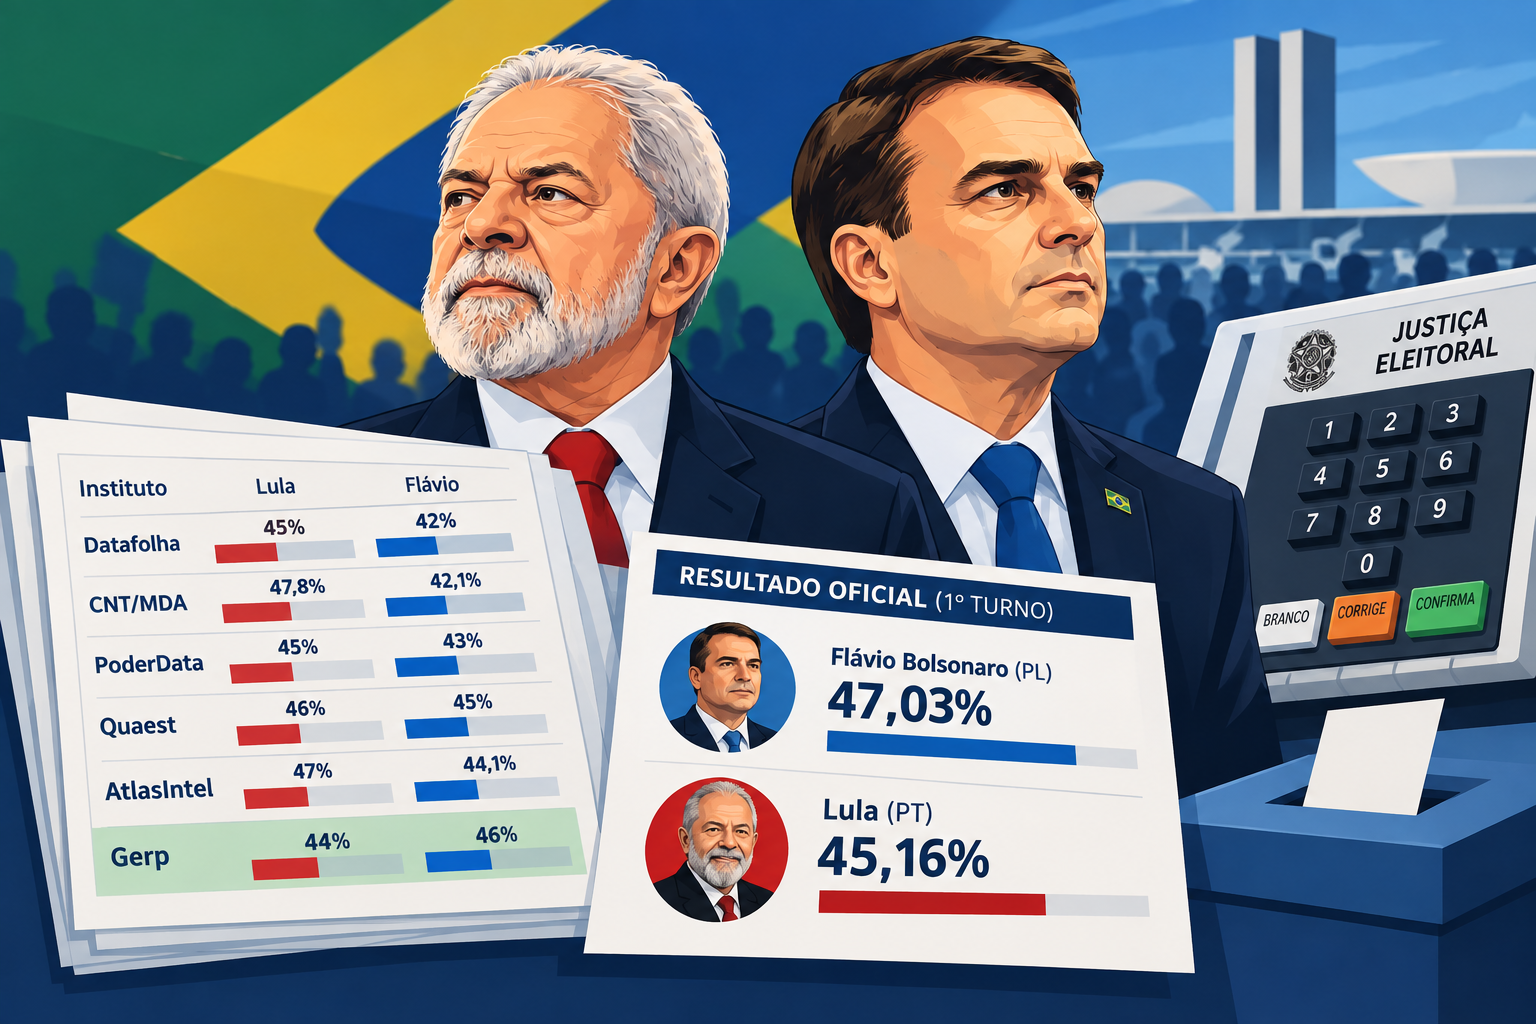
O resultado das urnas do primeiro turno das eleições de 2026 impôs um duro teste aos institutos de pesquisa eleitoral. Os números oficiais mostraram um cenário diferente daquele apresentado pela maioria dos levantamentos divulgados às vésperas da votação: Flávio Bolsonaro (PL) terminou na liderança, com 47,03% dos votos válidos, enquanto Lula (PT) ficou com 45,16%.
Na reta final da campanha, entretanto, cinco dos seis institutos analisados apontavam Lula numericamente à frente de Flávio Bolsonaro.
Continua depois da Publicidade
A exceção foi o Instituto Gerp
O levantamento do Gerp divulgado antes da votação indicava 46% para Flávio e 44% para Lula. O resultado das urnas foi de 47,03% e 45,16%, respectivamente. As diferenças ficaram dentro da margem de erro de dois pontos percentuais informada pelo instituto.
O contraste com os demais levantamentos chama atenção.
Cinco institutos colocaram Lula à frente
Na véspera da eleição, o Datafolha apontava 45% para Lula e 42% para Flávio. Nas urnas, Flávio alcançou 47,03%.
O CNT/MDA projetava 47,8% para Lula e 42,1% para Flávio. O resultado oficial foi praticamente o inverso da ordem apresentada pela pesquisa: Flávio terminou com 47,03% e Lula com 45,16%.
O PoderData estimava 45% para Lula e 43% para Flávio. A votação oficial registrou Flávio com 47,03%.
A Quaest apontava 46% para Lula e 45% para Flávio. Nas urnas, o candidato do PL terminou 1,87 ponto percentual à frente.
Já o AtlasIntel apresentava 47% para Lula e 44,1% para Flávio. O resultado oficial foi de 45,16% para Lula e 47,03% para Flávio.
Em outras palavras, a maioria das pesquisas não apenas errou os percentuais: errou também a ordem dos dois candidatos.
A diferença não foi pequena em alguns levantamentos
O tamanho dos desvios torna o episódio ainda mais relevante.
O Datafolha estimou 42% para Flávio, que acabou obtendo 47,03% — uma diferença de 5,03 pontos percentuais.
No CNT/MDA, a diferença foi de 4,93 pontos.
No PoderData, chegou a 4,03 pontos.
Na Quaest, foi de 2,03 pontos.
No AtlasIntel, de 2,93 pontos.
O Gerp apresentou uma diferença de apenas 1,03 ponto percentual na estimativa de Flávio.
Esses números não permitem concluir, por si só, que tenha havido manipulação ou fraude. Pesquisas eleitorais estão sujeitas a diferentes tipos de erro e medem a intenção de voto em determinado momento, não o resultado futuro da eleição.
Mas os números das urnas levantam uma questão incontornável: por que cinco institutos chegaram a um diagnóstico semelhante na véspera e o resultado oficial apresentou uma configuração diferente?
O caso Gerp ganha destaque
O desempenho do Gerp chama atenção justamente por ter apresentado, antes da votação, uma fotografia diferente daquela divulgada pela maior parte dos demais institutos.
Enquanto Datafolha, CNT/MDA, PoderData, Quaest e AtlasIntel colocavam Lula à frente, o Gerp apontava Flávio Bolsonaro na liderança.
A pesquisa ouviu 2.400 pessoas entre 30 de setembro e 2 de outubro, pelo método de entrevistas telefônicas assistidas por computador (CATI). O instituto informou margem de erro de dois pontos percentuais e nível de confiança de 95,55%.
O resultado oficial acabou ficando dentro dessa margem para os dois candidatos.
O eleitor tem o direito de cobrar explicações
A divergência entre pesquisas e urnas recoloca no centro do debate a qualidade dos modelos utilizados pelos institutos.
Não basta divulgar percentuais. É preciso explicar como as amostras são construídas, como os entrevistados são selecionados, quais critérios de ponderação são utilizados e como são tratados fatores como recusa, abstenção e mudanças de opinião na reta final.
A margem de erro também não deve ser utilizada como explicação automática para qualquer diferença. Ela representa uma medida de incerteza estatística, mas uma pesquisa pode estar sujeita a outras fontes de erro, relacionadas à própria composição da amostra e ao método de coleta.
A urna é o teste definitivo
A eleição de 2026 deixa um contraste que não pode ser ignorado.
Cinco institutos apontavam Lula à frente. As urnas apontaram Flávio Bolsonaro na liderança. O Gerp foi a exceção entre os levantamentos analisados e apresentou, na véspera, uma fotografia mais próxima da ordem efetivamente registrada no primeiro turno.
Isso não transforma pesquisa em previsão nem permite afirmar que um instituto sempre acertará e outro sempre errará.
Mas impõe uma cobrança legítima: os institutos precisam explicar ao eleitor por que suas fotografias da reta final ficaram tão distantes da realidade registrada nas urnas.
No fim, a pesquisa pode indicar uma tendência.
Mas é a urna que encerra a dúvida.
Gerp foi a exceção
O Gerp apresentou o cenário mais próximo da ordem final da eleição entre os seis institutos analisados.
A pesquisa apontava 46% para Flávio e 44% para Lula. As urnas registraram 47,03% e 45,16%.
As diferenças foram de 1,03 ponto para Flávio e 1,16 ponto para Lula, ambas dentro da margem de erro declarada de dois pontos percentuais.
Isso não significa que o instituto tenha “previsto” o resultado — pesquisas não são previsões das urnas —, mas mostra que sua fotografia eleitoral na véspera ficou mais próxima do resultado efetivamente registrado.
O retrato da véspera não correspondeu ao retrato das urnas
Os números podem ser resumidos assim:
| Instituto | Flávio na pesquisa | Flávio nas urnas | Diferença | Lula na pesquisa | Lula nas urnas |
|---|---|---|---|---|---|
| Gerp | 46% | 47,03% | +1,03 pp | 44% | 45,16% |
| PoderData | 43% | 47,03% | +4,03 pp | 45% | 45,16% |
| CNT/MDA | 42,1% | 47,03% | +4,93 pp | 47,8% | 45,16% |
| Datafolha | 42% | 47,03% | +5,03 pp | 45% | 45,16% |
| Quaest | 45% | 47,03% | +2,03 pp | 46% | 45,16% |
| AtlasIntel | 44,1% | 47,03% | +2,93 pp | 47% | 45,16% |
Os dados são referentes às pesquisas divulgadas na véspera e ao resultado oficial do primeiro turno.
O que explica tamanho descompasso?
É aqui que começa a discussão que interessa ao eleitor.
Uma pesquisa eleitoral não é uma contagem de votos. Ela trabalha com uma amostra da população e está sujeita a erros amostrais e não amostrais. O problema surge quando diferentes levantamentos, utilizando metodologias próprias, apresentam um quadro semelhante e o resultado das urnas produz uma fotografia consideravelmente diferente.
No caso analisado, a questão não é simplesmente perguntar “qual instituto acertou?”.
É preciso perguntar:
Por que cinco institutos apresentaram Lula numericamente à frente na véspera se Flávio terminou o primeiro turno na liderança?
E mais:
Por que alguns levantamentos subestimaram a votação de Flávio em aproximadamente quatro ou cinco pontos percentuais?
Essas diferenças merecem uma análise detalhada dos critérios de amostragem, ponderação, perfil dos entrevistados, taxa de recusa, método de coleta e período das entrevistas.
Margem de erro não pode virar salvo-conduto
Outro ponto que precisa ser esclarecido ao público é a margem de erro.
Ela não significa que qualquer resultado está automaticamente correto. O erro amostral é apenas uma das fontes de incerteza de uma pesquisa.
Uma pesquisa pode apresentar margem de erro de dois pontos e, ainda assim, sofrer problemas relacionados à composição da amostra, à participação dos entrevistados ou à forma como os dados são ponderados.
Por isso, diante dos números de 2026, a discussão não deveria terminar com a justificativa de que “a margem de erro explica tudo”.
Em alguns casos, os desvios observados para Flávio foram superiores à margem declarada. No AtlasIntel, por exemplo, a diferença entre a estimativa para Flávio e o resultado das urnas chegou a 2,93 pontos, contra uma margem informada de apenas um ponto. No Datafolha, foram 5,03 pontos diante de uma margem de dois.
Uma crise de credibilidade?
Os números, por si só, não permitem afirmar que houve manipulação ou fraude por parte dos institutos. Essa seria uma conclusão que exigiria evidências adicionais.
Mas permitem afirmar algo mais objetivo: houve erros relevantes de mensuração em parte das pesquisas divulgadas na reta final do primeiro turno.
E isso tem consequências.
Pesquisas eleitorais influenciam o debate público, a cobertura jornalística, as estratégias das campanhas, a percepção dos eleitores e até a interpretação do ambiente político.
Quando a realidade das urnas apresenta um cenário diferente daquele repetido por vários levantamentos, a confiança do público nesses instrumentos naturalmente entra em discussão.
O resultado de 2026, portanto, deixa uma pergunta inevitável para os institutos: o que aconteceu com as amostras e os modelos utilizados nos últimos dias antes da votação?
A resposta não deveria ser apenas política. Deveria ser técnica, transparente e pública.
Porque, no fim da eleição, quem fornece o resultado definitivo não é a pesquisa.